
新型「Mac mini」「Mac Studio」徹底レビュー! ローカルAIはついに“実用域”へ エージェントAIに事務仕事を任せて分かった驚異の進化
0
2026年09月22日 06:10 ITmedia PC USER


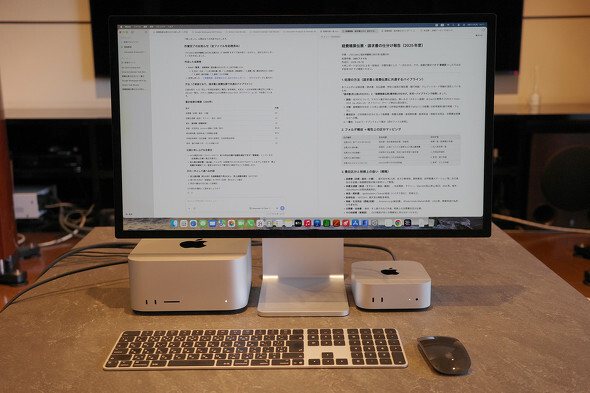
発表から約1カ月――9月22日、ついに新型の「Mac mini」「Mac Studio」が発売される。
発売に先んじて、Appleから1週間ほど新しいMac mini/Mac Studioを借りて試すことができた。Mac miniがM6チップ(12コアCPU+12コアGPU)/32GBメモリ/2TB SSD/10Gbps有線LAN、Mac StudioがM5 Ultra(36コアCPU+80コアGPU)/256GBメモリ/4TB SSDという構成で、Apple Storeにおける販売価格は前者が41万9800円、後者は217万3800円となる。
今回は、公開されているAIモデルを2台のマシンに載せた、指示すれば一連の作業を自分で進める「エージェントAI」を1日中働かせて、事務仕事にどこまで使えるかという点に焦点を絞ってレビューすることにした。
最新プロセッサを搭載したデスクトップPCということもあり、Mac miniであってもそこそこパワフルだ。長年のパートナーになれるだけのポテンシャルもある。ただ、このことはベンチマークテストの結果を見れば一目瞭然だ。
|
|
|
|
新しいMac mini/Mac Studioを見る上で重要なポイントは、「AIを動かすコンピュータ」という観点での大きな変化だ。それは驚きの連続で、特にMac Studioの場合はクラウドAIに任せていた仕事が、ローカル環境で完結できるようになった。Mac miniもAI処理パフォーマンスが向上しているので、「エージェンティックな処理をある程度ローカルに任せて、朝起きたときにレポートを見れば何をすべきか分かる」という使い方ができる。
コンパクトな AI モデルでもここまで動くようになるとは、知識としては知っていても実際に体験すると驚きでしかない。
●「ローカルAI」がより実用的になった秘密は?
特に個人がローカル環境で生成AIを動かすことは、少し前まで趣味の領域に近かった。「やってみたら動いた!」「おお、びっくりしたよ!」といった程度の話である。
それが2026年に入ると、個人でもローカルAIを動かすことが実用の域に達した。特にMacは他のプラットフォームと比べて有利なポイントもある。
|
|
|
|
理由その1:「ユニファイドメモリ」という考え方が広まった
理由の1つ目がメモリアクセスの構造変化だ。もっとも、この点はApple Siliconを搭載するMacでは元々解決していることでもある。
AIモデルは、稼働時に本体プログラムを丸ごとメモリに載せる。そのため、載せられるモデルの大きさは、メモリの量に比例する。処理にGPUを使う一般的なPCやサーバの場合、システムメモリとは別にGPU専用の「グラフィックスメモリ(VRAM)」が存在し、VRAMの容量が動かせるモデルの大きさを左右することになる。
それに対して、Apple Siliconの場合はCPUとGPUが同一のメモリを共有する「ユニファイドメモリ」というアーキテクチャを採用しているので、搭載しているメモリの容量が、動かせるモデルの大きさに“直結”する。PCという枠組みのまま、Mac Studioなら最大256GB(10月下旬からは最大512GB)をGPUで動くモデルに割り当てられる。
ユニファイドメモリ自体は、AMDの「Ryzen AI Max」シリーズや、NVIDIAの「RTX Spark」といったWindows PC向けプロセッサ、あるいはRTX Sparkのベースになったと思われる「DGX Spark」でも採用されている。しかし、これらのプロセッサはM5 Ultraチップ(毎秒1.2TB)と比べるとメモリ帯域が狭い(毎秒256〜273GB)という課題を抱えている。
|
|
|
|
今のところ、ユニファイドメモリを使いつつ広いメモリ帯域を確保しようとすると、Appleのプラットフォームしか選択肢がない。
理由その2:メモリのアクセス速度向上
理由の2つ目として、その大きなメモリを「読む」速さが変わった点が挙げられる。
生成AIの中核となるLLM(大規模言語モデル)の仕事は、入力を読み込む「プロンプト処理(プリフィル)」と、答えを1トークンずつ出す「生成」に分かれる。前者の処理は行列演算の“塊”なので、そのパフォーマンスはGPUの演算能力で決まる。一方、後者のパフォーマンス演算結果を展開する場としてのメモリ帯域で決まる。
従来のApple Siliconは、メモリ帯域の広さが生きる生成は高速だったのだが、プロンプト処理が遅いという課題を抱えていた。端的にいうと「後処理は速いけど、前処理が遅くてポテンシャルを発揮できない」という状況だった。大量の文書を渡してから、最初の一文字が出るまで何分も待つのでは、いくら生成が速くても仕事にならない。
この弱点を克服すべく、AppleはM5チップファミリーからGPUコアに「Neural Accelerator(ニューラルアクセラレーター)」という行列演算に特化した回路を追加した。前処理も高速にこなせるようになったため、処理速度の全体的な向上につながっている。
llama.cppの開発元が公開している性能表では、M5 MaxチップのLLaMA 7Bのプロンプト処理が毎秒3220トークンで、M4 Maxチップの886、M3 Ultraチップ(80コアGPU)の1471を大きく上回る。
M5 Ultraチップがうたう「M3 Ultraチップ比でAI性能4.5倍」は、プロンプト処理の高速化のことを指している。
理由その3:小型AIモデルの改善
理由の3つ目として、小さなAIモデルが賢くなったこともある。
昨今のAIでは、「MoE(Mixture of Experts)」という仕組みを取り入れていることがある。これは大きなAIモデルの中に特定の専門領域に特化した小規模モデルを複数入れるというもので、メモリ上に全てのモデルをロードしておかないといけない点に変わりはないが、処理時にアクセスする領域(容量)を小さくできるので応答速度を改善できるというメリットがある。2026年に入って、「1000億〜3000億パラメーターの規模の大規模モデルながらも、実際に動くのは100億パラメーター前後」という中型MoEが一気に増えた。
AIの生成速度は「メモリ帯域÷動作時に読み込むデータ量」でほぼ決まるため、MoEという仕組みは帯域の限られたローカルLLMとの相性がいい。今回レビューしたMac miniでも、270億パラメーター級のMoEなら実用的なパフォーマンスを発揮する。
理由その4:ソフトウェアがそろった
そして4つ目の理由として、ソフトウェアがそろった点も忘れてはならない。
Apple SiliconでAIを動かす基盤は、Apple自身が開発する「MLX」がけん引してきたが、オープンソースのllama.cppも「Metal 4」のテンソルAPIを通してNeural Acceleratorを使うようになった。
また、モデルを容易にダウンロードして動かせる「LM Studio」から、6月には別マシンのモデルを利用するための仕組み「LM Link」、7月にはエージェントアプリ「Bionic」が登場した。さらに、「Perplexity」が9月1日、エージェント自体はクラウド経由で利用しつつ、機密情報だけローカルのMacで処理できる「Hybrid Compute on Mac」が登場した。
このように、MacにおけるAI環境は急速に整ってきているのだ。エージェントAIを動かしやすい環境で、開発コミュニティーが活性化するのは自然な流れもある。「OpenClaw」「Claude Code」「Codex」「Hermes」あたりであれば、Mac miniとの相性も極めていい。
メモリアーキテクチャ、Apple製プロセッサのAI処理強化、小さくて賢いモデルの勃興、そしてソフトウェア環境――この4つがそろったこのタイミングで、新しいMac miniとMac Studioは従来のデスクトップ機とは異なる評価がされるべきものになった。
●Mac StudioをAIサーバとして動かす
さて、ここからはM5 Ultraチップ搭載のMac Studioに2つのAIモデルをダウンロードして「AIサーバ」として運用してみよう。
まず、大量の文書処理を行うことを想定して、「DeepSeek V4 Flash」の2840億パラメーター仕様(活性130億/MITライセンス)を導入してみたのだが、これが驚くような性能を発揮してくれる。
画像は扱えないが、文章に限れば非常に賢く、コンテキスト(一度に読み込み、把握できる情報量)は最大100万トークンまで対応する。文庫本/新書換算すると5〜8冊程度の文章量だ。モデルのサイズは4bit量子化版なら140GB台に収まるため、残りのメモリをコンテキスト長に割り当てられる。
DeepSeek V4は入力を圧縮して記憶する構造となっているため、今回レビューする256GBメモリ構成ならコンテキスト長を「256K」に設定しても“余裕”がある。別のAIモデルと同居させつつ、切り替えながらタスクをこなすことが可能だ。
そして“正確さ”が必要な日々の仕事を想定して、Alibabaが8月に公開した「Qwen3.8-27B」(Apache 2.0ライセンス)も導入してみたのだが、これも使い勝手が良かった。
コンテキストは最大26万トークンにとどまるが、こちらはマルチモーダル対応で画像も読める。こちらは8bit量子化版(約29GB)を余裕でロード可能だ。伝票の金額やメールの仕分けなど、間違えられたら困る処理は、量子化ビット数を上げたモデルで誤りを減らす方がいい。トランザクション処理ならコンテキストは「32K」程度でも十分で、会議録のような長めの入力でも「64K」あれば大丈夫だろう。
ただ、このモデルは推論が遅いことが難点であるため、実際に使う際は推論を「ゼロ」か、浅めに設定するのが良い。
2つのAIモデルは合わせて215GB〜220GB程度のメモリを消費する。AIモデルのメモリ容量を合計で240GB程度までにしておけば、メモリにロードしたまま併存もできる。
LM Studioであれば、APIから呼ばれたモデルを自動でロードし、使わなくなってから一定時間(標準で60分)経過するとアンロードする仕組み(JIT Load/TTL)があるので、別の専門モデルを呼び出したい場合はそれをうまく使えば対応可能だ。
準備ができたところで、ある1日で複数の“仕事”をさせてみることにした。
朝、スキャンした伝票と経費の写真が入ったフォルダーをLM Studio Bionicに渡し、定型処理を記憶させたスキルを起動する。するとQwen3.8-27Bが「日付」「支払先」「金額」を読み取って表計算シートに書き出し、「二重提出」と「金額の不一致」にチェックを入れる。
筆者の環境では20枚ほど渡したところ、30分以内には処理を完了し誤読は1枚だった。「誤読があるのか」と思うかもしれないが、誤読した不明瞭な伝票は「不明な伝票」としてはじいていたので、誤読の心配はない(これだけを手動入力すればいい)。
日中の会議では、Bionicの音声入力をオンにしておくと発言がそのままテキストになり、指定したフォルダーに保管されていく。そのフォルダーを丸ごとDeepSeek V4 Flashに渡してから「議事録を作成した上で、決定事項と未解決事項をまとめておいて」と頼んでおけば、別の作業をしているうちに記録される。
Bionic自体には自動実行機能はないが、「自動でやってほしい」というのであれば必要に応じてOpenClawを別途動かしておけばいい。
会議が終わった後、架空の契約書の束(10万トークン超)を同じモデルに一括で渡して処理させてみたが、支払条件の食い違いを“全て”見つけられた。うまくいった手順は、「今やったことをスキルにして」といえば保存され、翌月からはスキル名を呼び出してお願いすれば一連の作業を一言で完遂してくれる。
決まった時刻に決まったタスクを実行したい場合は、先述のOpenClawのような自動実行型のエージェントも必要だ。macOSのショートカットや「launchd」を介してLM StudioのAPIを叩いて自動実行することもできる。どのモデルを使って処理するかは、リクエスト時の文章で書くだけで、LM Studioが自動的に振り分けてくれる。
リモートでも使える!
このAIサーバはリモートでも使える。Mac StudioでLM Linkをオンにすると、MacだけではなくWindows PCのLM Studio Bionic、あるいはiPhone/iPadの「Locallyアプリ」から接続し、まるでローカルにあるAIモデルのように使える。通信は端末同士で暗号化され、会話履歴は手元に残ってサーバには残らない。エージェントの本体が作成するファイルの読み書き、ローカルツールの実行は各自の手元で動き、推論だけをMac Studioにリモートで依頼できる。
●M5 Ultraチップでの画像生成も試す
Mac Studioのメモリ搭載量の多さを生かして、Mac向けStable Diffusionアプリ「DiffusionBee」において、最大規模のモデル「FLUX.1 dev」を用いて、テキストからの画像生成テストも行ってみた。
FLUXのような拡散モデルでは、プロンプトを長く複雑にしても生成時間はほとんど増えない。その後の「デノイジング処理」の計算量を決めるのは、主に解像度とステップ数である。
掲載している画像は768×768ピクセルのもので、生成テストにちょうどいいサイズ感だ。この程度なら1枚当たりわずか50秒で生成される。何度もリトライを繰り返せる速度感だ。
なお、FLUX.1 devのテキストエンコーダーは512トークン程度が上限で、それを超えた部分は切り捨てられるため、その上限ギリギリに収まるようテストは行っている。FLUX.1は商利用できないライセンスだが、このモデルでサクサク動くならば、他のモデルを使っても実用性の高い画像生成が行えるはずだ。
●Mac miniでAIをたしなむ
AI視点で見た場合、Mac Studioが「部署で共有するAIサーバ」なら、Mac miniは「机の上で1日中動く、手近なエージェントマシン」といえる。M6チップのメモリは最大32GBなので、最大限メモリを搭載した場合にGPUに割り振れるのは28GB程度が限界だろう。「20GB前後で収まるAIモデルを1つロードする」という使い方が現実的で、それに当てはまるモデルは以下のものだ。
・Gemma 4 26B-A4B(4bit量子化/約15GB)
・Qwen3.6-35B-A3B(約20GB)
・Qwen3.8-27Bの4bit版(約17GB)
・Muse Glimmer 30B(20GB弱)
メモリ帯域幅も毎秒170GBと、M5 Ultraチップ搭載のMac Studioとは桁が“2つ”違うので、使うのであれば専門性を高めたMoEが適している。
今回行ったテストでは、Gemma 4 26B-A4Bにおいて毎秒26トークン程度のパフォーマンスを得ることができた。小型モデルであることを差し引いても、かなり実用的に使えるスループットだ。
さすがにGPUの規模が大幅に違うため、プリフィルのパフォーマンスは良好とはいえない。それでも、書類を月次/週次単位でまとめて処理したり、常駐エージェントを毎朝走らせたりする程度なら問題はない。
試しに40枚の領収書と請求書が混じったPDF伝票を分類/集計させてみたが、間違いなく仕事をやりきり、事前処理は4分20秒程度で済んだ。トークン出力は前述したように毎秒26トークン前後と良好だ。JPEG形式で保存した領収書伝票の画像も、20枚を5分ほどでOCRして処理を完了する。
この程度の規模でも近年のMoEモデルは優秀で、用途を見定めるのであれば、十分に使い道はあるのだと実感した。仕事し始めのちょっとした事前の振り分けを依頼できるレベルには達している。
MCP(Model Context Protocol)で接続されているツールから集めている自分向けのメッセージや書類を読み込み、その内容に応じて対応すべきアクションをまとめたり、メールや業務ワークフローツールから届いているフォルダーの中身を内容で仕分けたり、スキャンしたPDFの名前を「日付_相手先_内容」に付け直したり、毎朝届く日報を3行にまとめたり、SafariのmacOS 27における新機能「Notify Me」で見張っているページの変化を要約したりといったように、単純な作業はオンデバイスAIによる事前処理が当たり前になっていくだろう。
LM Studio Bionicを使う場合でも、OpenClawを使って定期的に常駐型エージェントを定期実行する場合でも、ローカルのストレージへの読み出し権限を与えれば、メールやカレンダーなどの個人情報について、ローカルに保存されているデータを調査して報告させることも可能だ。
実際に、(今回のレビュー機ではないMacBook Proだが)筆者はこうした情報をローカルLLMのエージェントに数時間に一度チェックさせ、明らかな広告メールやSNS関連通知は優先順位が低いものは削除、残す価値のあるものは既読にして、必要な応答優先順位のリストを報告させているが、問題が起きたことはまだない。
Siri AIも使える
もう1つ、M6チップを活用できる新要素もある。macOS 27で始まった「Siri AI」と30億パラメーターの「AFM 3 Core」、200億パラメーターを持ちながら推論時には10〜40億だけを動かす「AFM 3 Core Advanced」の2種類からなるAppleの第3世代「Foundation Models」だ。
これらはGPUだけでなく「Neural Engine」(NPU)も併用され、ほとんどの場合は省電力なNeural Engineで動いている。M6チップの2基のNeural Engineは、チップ内でつながっていて従来の2倍のパフォーマンスを発揮する。BionicがGPUを回してエージェントで仕事をしている最中にも、AFMを通して動くツールを並行して動作させることも可能で、Siri AIもフル活用できる。
Siri AIは現時点では英語のみ一般β提供しているが、日本語も開発者向けβテストが始まっており、筆者も試しているところだ(一般βは10月から提供予定)。AFM対応アプリや、Siri AIと連携できるアプリも、今後は増えてくるだろう。
FP8演算できるのも強み
加えて、M6チップファミリーのGPUではNeural Acceleratorに改良が加えられ、FP8のネイティブ演算が可能となった。これにより、量子化でコンパクトに仕上げたAIモデルの実効性能が高まっている。
Neural Engineの倍増とともに、小型モデルが並行して動く時の実用性を高めているわけだ。 メモリ帯域が毎秒170GBに向上したことも含め、ローカルAIで“パーソナルな”コンピュータをより使いやすくすべく、システム全体を見直した結果の強化ともいえる。
この辺りはOSやソフトウェア開発環境、Mac本体だけではなく、プロセッサまでをトータルで設計し、擦り合わせているAppleの強みが発揮できている点だ。今後はM6チップを積んだMacBook Proが登場するとみられており、この構成がこれから数年のMacのスタンダードになるだろう。
AI時代においてクライアントコンピュータがどのような使われ方をするのか、新しいスタート地点が設定されたという印象だ。
●処理パフォーマンスを「数字」で確かめる
M5 Ultraチップ搭載のMac Studioの処理パフォーマンスを「数字」で確かめておこう。
llama.cppの公開表と同じ条件、具体的には「LLaMA 7B Q4_0」を使って「512トークンの読み込み」「128トークンの生成」を実行してみたところ、Mac Studioはプリフィルが6298、生成速度は毎秒204.5トークンだった。これはM5 Maxチップ(プリフィル3220/生成毎秒119.9トークン)に対して2倍程度、M3 Ultraチップ(プリフィル1471/生成毎秒92.1トークン)とは比べるまでもない。
M5 UltraチップはM5 Maxチップを2基連結したようなチップ構成なので「2倍程度」という性能差は妥当といえる。
同じテストをM6チップ搭載のMac miniでもやってみたところ、プリフィルは876、生成速度は毎秒35.8トークンだった。
先代はM4チップを搭載していたため、期待値は先代比で「プリフィルが4倍、生成速度は1.5倍」だったが、実測するとプリフィルが221、生成速度が毎秒24.1トークンだったので期待通りの結果だ。
Mac StudioにおけるDeepSeek V4 Flashでは、16Kトークンのプリフィルが毎秒112トークン、生成は毎秒56トークン前後を示した。比較的複雑な指示をしたのだが、生成開始までの時間はおよそ120秒だった。
「え、ちょっと時間かかってない?」と感じるかもしれないが、実は従来のMac Studioと比べると体感的に4倍以上高速になっている。気持ちよい程度には、速度が出る。
別途、10万トークンの矛盾を内包した20通の契約書を生成しておき、その矛盾点を探る処理を行わせたところ、生成開始まで約54秒で、その後の生成速度は一般的なクラウドのAIサービスと変わらなかった。少なくともエージェントとして、業務をバックエンドで支える存在として捉えるなら極めて実用的だと感じた。
なお、ここまで劇的に処理が高速化した背景には、LM Studioに内包されているllama.cppがM5チップ世代に対応した影響も大きい。7月に公開された「BaseRT」という研究用の実行環境では、Metal 4を直接使うことでM5 Proチップにおけるプリフィルをllama.cppの最大6.4倍まで引き上げたと報告している。
DeepSeek V4 Flashは公式版でMLXをサポートしていないものの(コンバート版はもちろんある)、さまざまな面でMacのAI性能を引き出せる環境が整いつつある。
●消費電力と価格はどうか?
Mac Studioの消費電力は100〜160Wとされている。ただし、生成AIをフルに回している時でも、静かに冷却ファンが回るだけで、けたたましい音を立てることはない。Mac miniに至っては、ほとんど無音といってもいい。
AI性能は高いのに、AIサーバでイメージされる消費電力の高さや発熱はほとんど気にならないのは強みといえる。
一方で、気になるのは本体価格だ。
M5 Ultraチップ搭載のMac Studioの最小構成価格は94万9800円だが、これだとメモリが96GBしかない。AIサーバとして使う場合は心もとなく、少なくとも256GBはほしい。今回の試用機のカスタマイズ(CTO)オプションを細かく見ると、チップの強化(36コアCPU/80コアGPU化)に23万4000円、メモリの増量(256GB化)に72万円で、ここまででも190万3800円となる。さらにストレージの増量(4TB化)を組み合わせると、冒頭で書いた217万3800円というプライスになる。メモリを512GBにした場合は、一体いくらになるのか、ちょっと想像できない。
本機はThunderbolt 5(USB4)接続で最大4台のクラスタリングにも対応している。まずは1台でスタートし、必要に応じて拡張するのが現実的……とはいうものの、個人事業主や企業で導入するにしても経費として落とせない額なので、「導入は計画的に」という所である。
一方、M6チップ搭載のMac miniの最小構成価格は14万9800円だ。ここからCTOオプションとしてメモリの増量(32GB化)に7万2000円、SSDの増量(2TB化)に16万円、内蔵LANの10Gbps化に1万800円と重ねていくと、試用機の41万9800円という価格に跳ね上がる。ここまで来ると、実はM5 MaxチップのMac Studioの最小構成モデルが買えてしまう。大きめのローカルAIを回したいという場合は、メモリを最大64GBまで積めるM5 ProチップのMac mini(29万9800円から)か、M5 Maxチップ搭載のMac Studioを選んだ方がいい。
M6モデルの価値は、別のところにある。小さなモデルで雑務を回し、Siri AIを手元で動かし、必要なときだけMac Studioで動く大きなモデルに接続する――これなら、32GBメモリでも十分である。
ローカルでAIを動かす理由は、この1年の段階では「できるならやってみよう」だったが、「ローカルの方が都合がいいから」に変わった。社外に出せないファイル、従量課金を気にせず何度でもリトライしたいタスク、席を外している間にもずっと動き続け、進めておいてほしい作業――これらをこなすために設計されたシステムという印象だ。
この2台は見た目こそ従来機と大きく変わっていないが、「どのような高速処理を目指すのか?」において、明確な方向転換を果たしている。
|
|
|
|
|
|
|
|
Copyright(C) 2026 ITmedia Inc. All rights reserved. 記事・写真の無断転載を禁じます。
掲載情報の著作権は提供元企業に帰属します。

IT・インターネット
ランキング IT・インターネット
アクセス数ランキング
- 1

投稿めぐり東国原英夫氏書類送検(写真:TBS NEWS DIG)99
話題数ランキング
- 1
投稿めぐり東国原英夫氏書類送検(写真:TBS NEWS DIG)99
