
理論値以上のゲーミング性能を発揮できる秘密は? MSI Claw 8 EX AI+で知る「Intel Arc G3 Extreme」の実力
0
2026年09月30日 18:11 ITmedia PC USER


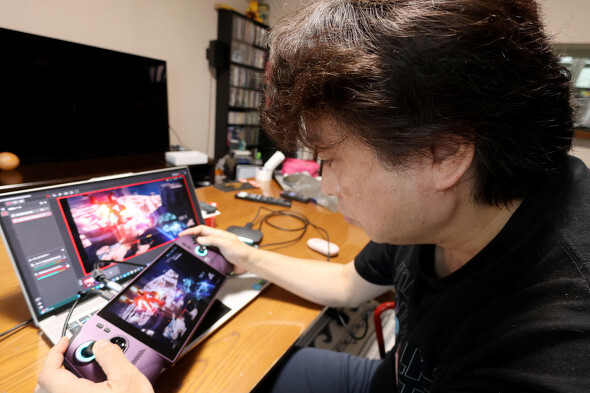
近年、ハンドヘルド型のゲーミングPC(ポータブルゲーミングPC)への注目が高まっている。といっても、既存のゲームプラットフォームを脅かすほどのブームではない。実際、この分野はニッチな世界の製品のままではあるのだが、「新ジャンル」として順調に市場規模を拡大している。
このタイプの製品が以前からなかったわけではないが、ここまでのブームに成長させた“仕掛け人”は、Valveが2022年に発売した「Steam Deck」だといえる。実際、Steam DeckはPCメーカーに広く影響を与え、2023年にはいわゆる中華メーカーを中心に各社から似たコンセプトの製品が登場した。特に大手PCメーカーのLenovoが「Legion Go」シリーズ、ASUSTeK Computer(ASUS JAPAN)が「ROG Ally」シリーズ、MSIが「Claw」シリーズをほぼ同タイミングで投入したあたりから、認知度がグッと広がった印象だ。
その多くがAMDのRyzenプロセッサ(SoC)を採用する中、MSIは積極的にIntelプロセッサを採用したモデルを投入している。今回取り上げる「Claw8-EX-AI-CG3EM-406JP」(以下「Claw 8 EX AI+」)も例外ではなく、Intelの最新モバイル向けCPUアーキテクチャ「Panther Lake」(開発コード名)をベースに、ポータブルゲーミングPCに最適化したSoC「Intel Arc G3 Extreme」を搭載している。
今回は、インテルから借りた実機に触れることができたので、その性能を探ってみたいと思う。
|
|
|
|
●Intel Arc G3 Extremeの「GPU」の性能をチェック
こうしたポータブルゲーミングPCに関心を抱くユーザーは、「どの程度のゲーミング性能があるのか?」という点に興味が集中しているはずだ。そこで、まず性能評価から行うこととしたい。その上で、本体回りやArc G3 Extremeの素性などの話題に切り込んで行こう。
最初はしっかりめの負荷をGPUに掛けられるゲームベンチマークテストを実行しようと考え、カプコンの「モンスターハンターワイルズベンチマーク」の利用を考えた。しかし、本アプリの配信は2025年1月をもって終了している。
しかし幸いなことに、同社は7月から「鬼武者 Way of the Sword」のベンチマークソフト(鬼武者ベンチ)を公開した。今回は、これを使って性能を確認することにする。
なお、鬼武者ベンチのダウンロードには「Steam」または「EPIC Store」のアカウントが必要となる。
|
|
|
|
鬼武者ベンチのベースとなっている鬼武者 Way of the Swordは、カプコンが誇るゲームエンジン「REエンジン」をベースに制作されており、グラフィックスの作り込みには高い評価が寄せられている。さらに、アクションゲームでありながらレイトレーシング(RT)にも対応している。
ある意味で、最新マシンのゲーミング性能を推し量るにはもってこいといえる。
Claw 8 EX AI+単体で測定しても絶対的な性能が分かりにくいため、ちょうどいい比較対象がほしい。たまたま、筆者は私物でASUS JAPANの「ROG Xbox Ally X」を所有しているので、これと比べることにした。
ROG Xbox Ally Xは、2025年時点ではポータブルゲーミングPC向けとしてほぼ最高性能クラスと言われていたSoC「Ryzen AI Z2 Extreme」を搭載している。Claw 8 EX AI+(Intel Arc G3 Extreme)の詳細なスペックに対する考察は次節以降に提示するが、ここでは、GPUの理論性能値だけをざっくりと比較しよう。
まずは、両SoCの主要スペックをまとめた下表を見てほしい。
|
|
|
|
GPUのピーク性能は、Claw 8 EX AI+(Intel Arc G3 Extreme)が7.07TFLOPS(毎秒7.07兆回)なのに対して、ROG Xbox Ally X(Ryzen AI Z2 Extreme)が11.88TFLOPS(毎秒11.88兆回)となる。単純に見ると、Claw 8 EX AI+比で1.68倍の演算能力を持つROG Xbox Ally Xはだいぶ高性能ということになる。
メモリ帯域はClaw 8 EX AI+が毎秒136GB、ROG Xbox Ally Xが毎秒128GBであり、Claw 8 EX AI+の方が7%ほど高速だが、大差といえるほどではない。
鬼武者ベンチマークは、描画解像度をフルHD(1920×1080ピクセル)にそろえた上で、パフォーマンスの違いが出るのか確かめるためにグラフィックスのプリセット設定を「中品質」「高品質」の2パターンで計測した。また、レイトレーシング(RT)の有効/無効による影響を見るため、「中品質」設定時にのみRT設定「中」でもテストを実施した。
●理論性能で不利ながらも実性能では勝つ!?
鬼武者ベンチの結果は以下の通りだ。
・Claw 8 EX AI+(Arc G3 Extreme)
・中設定/レイトレーシングOFF:1万5073ポイント
・中設定/レイトレーシング中:1万3689ポイント
・高設定/レイトレーシングOFF:1万3662ポイント
ROG Xbox Ally X(Ryzen AI Z2 Extreme)
・中設定/レイトレーシングOFF:1万3897ポイント
・中設定/レイトレーシング中:1万2280ポイント
・高設定/レイトレーシングOFF:1万2619ポイント
ポータブルゲーミングPCのCPU(SoC)の世界では、Ryzenシリーズが長年トップの座に君臨してきた。だからこそ、この分野の古参ユーザーほど、理論的には勝ち目がなさそうなArc G3 Extremeが全てのテストで勝利を収めたという今回の結果には驚いていると思う。
ただ筆者は、2026年1月にArc G3シリーズのベースとなるPanther Lake(開発コード名)の内蔵GPUの優秀さを目の当たりにしていたので、そこまでの驚きはない。むしろ「Arc G3 Extremeの内蔵GPU(Arc B390 Graphics)恐るべし」という納得感が強まった。
なお、実際の動きがどんなものかチェックしたい人のために、それぞれの動作を動画として収録した。参考にしてほしい(映像は別のPCを使って録画しているため、ベンチマーク機のパフォーマンスには影響していない)。
もう少し結果を詳しく見ていこう。
まず、同じ設定におけるスコアを比較するとClaw 8 EX AI+はROG Xbox Ally X比で8%程度高い。この差は「計測誤差」ではなく、有意に「性能差」と言ってよい。明らかにClaw 8 EX AI+の方がゲーミング性能は“上”だ。
「まぁ、そういうこともあるでしょうよ」という意見はごもっともだが、先述した通り、理論的な性能だけを見ると1.68倍ほどの開きがある。なのに、ここまでの“逆転劇”を演じるのは珍しいことなのだ。この逆転劇に対する考察は、後ほど行う。
そしてもう1点、RTを有効化した場合のパフォーマンスの落差がClaw 8 EX AI+の方が小さいことも注目に値する。落ち込み幅はROG Xbox Ally Xが約11.6%だったのに対して、Claw 8 EX AI+は約9.2%に抑えられている。逆に、同一ハードウェアにおける「中設定」と「高設定」の落差は、共に約10%で、負荷の増加割合は同等だったようだ。
2026年9月時点では、TDP(熱設計電力)が40W以下クラスのゲーミング性能重視型ポータブルゲーミングPCを選ぶ場合、信じられない人も多そうだが、Claw 8 EX AI+(Arc G3 Extreme)に軍配が上がるということになる。
「ではRyzenはこのまま崩れ去るか?」と言えば、筆者はそんなことはないとも考えている。このことも、後ほど触れることにしたい。
●実際にゲームをやってみるとどう?
「実際のゲームをプレイしている様子を見比べたい!」という人は、フロムソフトウェアの「ARMORED CORE VI FIRES OF RUBICON」(アーマードコア6)をプレイした動画を用意したので、参考にしてほしい。「なぜこのタイトルか?」といえば、シンプルに筆者が大好きだからである(笑)。
解像度はフルHDで、グラフィックスは「高設定」としている。
Claw 8 EX AI+の方は、「高設定」でも40〜60fpsで動作している。これはなかなかに立派といえる。「中設定」にすると、下限の40fpsの部分がもう少し底上げされるような感じだ。
一方で、同一条件でROG Xbox Ally Xを使って遊ぶと、高負荷時の最低フレームレートは35fpsあたりになる。そういう意味ではClaw 8 EX AI+と大して変わらないが、40〜50fpsあたりのフレームレートだと、Claw 8 EX AI+が常時2fpsくらい上回るイメージだ。
先のベンチマークテストで出てきた8%程度のスコア差は、この「常時2fpsくらい上回る」という所に現れている。
この後は、このベンチマークテストの結果を“深掘り”していこう。
●Arc G3 ExtremeもRyzen AI Z2 Extremeもスペックを“盛っている”
理論性能値だけを見ると大差を付けられているArc G3 Extremeが、なぜゲームパフォーマンス、いやグラフィックス性能においてRyzen AI Z2 Extremeを“しっかりと”上回っているのか。
これについて、GPU回りに詳しい人なら「『RDNA 3』以降のRadeonはGPUコア(Compute Unit:CU)を増やさずに、CU当たりのSIMD演算器を増やしただけだけ。理論性能は上がるけど実行性能はそれほど上がらないのは当然ですよ」とツッコむだろう。でも、ちょっと待ってほしい。実は、IntelもPanther Lakeの内蔵GPU(Arc B300シリーズ)で同じ方向性の「改良」を受けている。
要するに、Arc G3 Extremeが内蔵するArc B390 Graphicsの「7.07TFLOPS」というピーク性能も“盛った”値と言えなくもないのだ。
順を追って解説したい。
SIMD演算器の追加は効果薄?
AMDはRDNA 3以降のアーキテクチャ、製品でいうと「Radeon RX 7000」シリーズ以降のGPUにおいてCU当たりのSIMD演算器を2倍に増やした。CU自体を2倍にせず、CUが搭載するSIMD(Single Instruction/Multiple Data:並列処理を行う手法の1つ)用の演算器を2倍としたのだ。これが、RDNA 3以降のRadeonシリーズにおいて理論性能値が高めに出る秘密である。
この2倍に増やしたSIMD演算器は、依存関係がないSIMD演算に限り同時並列で動かせる「デュアルイシュー」を実現できる一方で、近代ゲームグラフィックスではデュアルイシューが働くケースが減ってきたとされる。もう少し具体的にいうと、シェーダープログラムの複雑化と高度化によって「依存関係のないSIMD演算」が減少し、結果としてSIMD演算器を2倍にしたことの恩恵を受けづらくなっているのだ。
強いていうと、「理論性能値ほどの実効性能が発揮できない」ことがRDNA 3以降のRadeon GPUの弱点である。
とはいえ、この方向性のチューニングはIntel Arcシリーズも同様である。
IntelのGPUアーキテクチャでは、Xeアーキテクチャの単位ベクトル演算器である「Xe Vector Engine(XVE)」におけるSIMDの実行レーン数は、初代Xe GPUでは8レーン(SIMD8)だったのに対して、2世代目のXe2 GPUでは16レーン(SIMD16)に倍増した。その代わり、XVE自体の数はXeコア1基当たり16基から8基に半減している。
一応、これらを式で表すとこうなる。
Xe GPUのXeコア1基当たりの演算器:SIMD8×16 XVE=128基
Xe2 GPUのXeコア1基当たりの演算器:SIMD16×8 XVE=128基
筆者は、この方針転換(構造改変)を「処理できるスレッド数を半分にする代わりに、一度にこなせる演算密度を増やした」と解釈している。ある意味で「命令パイプラインを太くして、実ワークロードでのハードウェア稼働率を底上げする」という、実戦的なアーキテクチャの最適化といえなくもないのだが、結局のところピーク時の理論性能(TFLOPS)の数字を稼ぐ設計とも表現できる。
“やり口”だけ見れば、RDNA 3以降のRadeon GPUも、Xe2 GPUも同じ改変をしているのだ。
Xe3 GPUはXeコアを増やして“同じこと”をやっている
Arc G3シリーズを含むPanter LakeアーキテクチャのSoCが内蔵する「Xe3 GPU」ではこれがどうなったかというと、Xeコアの構成自体は変えずに、1つのRender Sliceに搭載するXeコアを4基から6基に増やすことで性能を強化している。
Render SliceにはXeコアだけではなく、「ラスタライザ」「ジオメトリパイプライン」「ピクセルバックエンド(ROP)」といった固定機能のグラフィックスハードウェアを内包している。NVIDIAのGPUでいうところの「GPC(Graphics Processing Cluster)」に相当し、これだけを切り出しても単体のGPUを機能を果たせるようになっている。
Arc G3シリーズにおけるXe3 GPUのRender Sliceは、ノートPC向けのSoCにおけるXe2 GPUと同じ2基しかない。
要するに、Xe3 GPUでは「Xeコアを4基に据え置いてRender Sliceの数を増やす」のではなく、「Xeコアを6基に増やしてRender Sliceの数を据え置く」という選択をしたのだ。少し言い変えると、固定機能のグラフィックスハードウェアの数はそのままにして演算器だけ増やしたということになる。
単位時間当たりのピクセルスループットはそのままで、ピーク理論性能(TFLOPS)の数字だけを稼ぐ設計の“延長線上”にあるともいえる。
このことについて、Xe3 GPUの“肩”を持つような解説をしておこう。
「Xeコアを6基に増やしてRender Sliceの数を据え置く」という選択は、昨今のゲームグラフィックスにおいてCompute Shader(コンピュートシェーダー)への依存度が上がっているという事実を踏まえたものだ。RDNA 3以降のRadeon GPUにおけるSIMD演算器の増量も、同じことがいえる。
今や、一部の高度なゲームエンジン(例えば「Unreal Engine 5」)では、特殊なライティングや特殊なラスタライズ処理まで、Compute Shaderで実践するようになっている。ゆえに、GPUがこの方向のチューニングを受けることは、ある意味でごく自然なことなのだ。
●理論性能で劣るArc G3 Extremeが“逆転”できた理由は?
GPUのチューニングの方向性が同じなのだとしたら、「なぜArc G3 Extreme(Arc B300シリーズ)の方が実パフォーマンスに優れるのか?」という疑問も沸いてくる。
以前、このことをIntelのGPU担当関係者に聞いたところ、「GPU内部のデータパスの最適化と、GPUコアからのメモリアクセスの最適化を極限まで進めた結果だと思っていい」と述べていた。どういうことなのか、解説しよう。
GPU内部のデータパスの最適化
先述の通り、Xe3 GPUでは,Render Sliceの数は据え置かれた。そのため、Xe2 GPUと比べると並列性の向上はない。
しかし「汎用(はんよう)レジスタファイル(GRF)」の割り当て粒度を動的に変化させることで、1基のXVEが実行できるスレッド数が「最大4〜8」から「最大10」まで向上している。
また、メモリのアクセス面に着目すると、Panther Lakeではグラフィックス専用のGDRメモリではなく、汎用性の高いDDR5/LPDDR5Xメモリを使う上に、バス幅も128bitと狭いため、GPUの性能を向上することが非常に難しい。
だがIntelは「メモリへのアクセスは極力避け、可能な限り高速なキャッシュメモリ内で処理を行い、データのやり取りを高速にするチューニングを施す」という策を取った。これに加えて、先述したGRFの割り当て粒度の動的変化によって、メモリアクセスが発生した場合に待ち時間で別のスレッドも実行できるようにしている。
これらの“地道”なチューニングが、テストスコアにおける“下克上”を起こした一因になっていると見られる。
GPUコアからのメモリアクセスの最適化
このあたりの説明だけだと「え、これだけで逆転できるの?」と信じられない人もいると思う。
ただもう1つ、下克上を起こした、分かりやすい大きな要因がある。それは「ラストレベルキャッシュ(LLC)メモリの容量」だ。Intelの説明における「GPUコアからのメモリアクセスの最適化」が、この部分に当たる。
Ryzen AI Z2 Extremeに搭載されているRDNA 3.5アーキテクチャのGPU「Radeon 890M」では、LLC(L2キャッシュ)の容量が2MBしかない。
「RDNA 2」以降のRadeon GPUでは、「Infinity Cache」という名称で大容量のL3キャッシュをLLCとして搭載してきた。RDNA 2では最大128MB、RDNA 3では最大96MB、RDNA 4では最大64MBと、世代を追うごとに減ってはいるものの、LLCとしてはかなり広大なことには変わりない。しかし、Radeon 890MにはInfinity Cache自体がないのだ。
実は、コンパクトワークステーション向けのSoC「Ryzen AI Max」シリーズ(開発コード名:Strix Halo)には、特別にInfinity Cacheの代わりとなる「MALL(Memory Attached Last Level)キャッシュ」が最大32MB搭載されている。これはI/Oダイに実装されているので、理論上はCPUにおけるLLCとしても使える。しかし、あえてGPU専用キャッシュとして稼働するように仕込まれている。
「これをRDNA 3.5アーキテクチャのRyzen Z2シリーズにも搭載できたら……」と思うと非常に惜しい。当然、Ryzen AI Max 300シリーズのGPUの方が高いパフォーマンスなのは言うまでもない。
Arc G3 Extremeのことに話を戻すと、このSoCが搭載するArc B390 GraphicsのLLCも、Radeon 890Mと同じくL2キャッシュなのだが、容量が8倍の16MBもある。GPUの性能の落ち込みはメモリアクセスが増大することにつながることを考えると、この8倍の差は大きい。
さらに、Arc G3 Extremeを含むPanther Lakeプロセッサには、MALLキャッシュに似た役割を果たす「Memory Side Cache(MSC)」を8MB備えていることも忘れてはいけない。
MSCは、GPUタイルではなくComputeタイルに搭載されているものの、メモリコントローラーに直結されているので、GPUのメモリアクセス内容もキャッシュ可能な構造となっている。システム全体のLLC的な存在ともいえる。
Intelの調べによると、この一連のキャッシュシステムの恩恵により、メモリアクセスが実に17〜36%も減少したという。これだけのメモリアクセス削減は、下克上の達成において大きな“追い風”になったことだろう。
Ryzen Zシリーズも今後、同様の改良が進むか?
ここで、Ryzen AI Z2 Extremeを含むRyzen Z2シリーズのフォローもしておこう。
Ryzen Z2シリーズのGPUアーキテクチャは先代の「RDNA 3」か、そのマイナーチェンジ版である「RDNA 3.5」であり、現行の「RDNA 4」よりも古い。RDNA 4では、Xe3 GPUの特徴でもある「スレッドの動的切り替え」や「可能な限りキャッシュメモリ内で処理を完結させる」といったチューニングを施している。
RDNA 4アーキテクチャは、2025年に比較的こっそり発表された「Radeon RX 9000」シリーズで採用済みで、RDNA 3で行った「CUにおけるSIMD演算器の倍増」について、その実効性能を高めるための調整も行っている。具体的な手法としては「同時実行スレッド数の向上」「メモリアクセスの順不同実行への対応」などが挙げられる。
これらの改善は、Xe3 GPUの高性能ぶりに“対抗”できるポテンシャルを持つのだが、現時点ではRDNA 4アーキテクチャのGPUを統合するSoCはまだ市場に出ていない。
“世代交代”を引っさげてのAMDの反撃が始まるのは、早くて2027年頃になるだろうか。
●Claw 8 EX AI+ってどんな感じ?
通常のレビュー記事とは順序が逆転する形になってしまったが、Claw 8 EX AI+の所感をまとめておきたい。
本体サイズは約321(幅)×130(高さ)×48(厚さ)mmで、ROG Xbox Ally Xの約290(幅)×121(高さ)×51(厚さ)mm、あるいはレノボ・ジャパンの「Legion Go 2」の約296(幅)×137(高さ)×42(厚さ)mmと比べると、少し幅を取る。Legion Go 2の高さは、より大きい8.8型ディスプレイを搭載していることに起因する。
Claw 8 EX AI+の画面サイズは8型で、ROG Xbox Ally Xよりも一回り大きい。パネルは最大120Hz駆動のタッチ対応IPS液晶で、解像度は1920×1200ピクセルだ。リフレッシュレートは可変式(VRR)で、輝度は最大500ニトと明るめだが、HDRには対応しない。
コントローラの操作感覚はよい。ボディーが大きい分、ホールドしやすい。ボタンの配置もXbox系コントローラーに近く、多くのPCゲーマーに受け入れられそうなデザインだ。
画面の左右にある4つのボタンは、左にあるのが「セレクト(View)ボタン」と「MSI Centerボタン」、右にあるのが「スタート(Menu)ボタン」と「クイックセッティングボタン」となる。
接続端子類は、本体上部に集中する。2基あるUSB Type-C端子は、共にThunderbolt 4(USB4 Version 1.0/USB 40Gbps)端子となっている。理論的に外付けGPUボックスも接続可能だ(対応可否は不明)。どちらの端子もUSB PD(Power Delivery)による給電と、DisplayPort Alternate Modeによる映像出力に対応するのも立派といえる。
この他、microSDメモリーカードスロットと3.5mmミニオーディオジャックを備える。オーディオジャックは4極型なので、マイク付きヘッドフォンにも対応する。
背面には、最近の新型コントローラーに採用される傾向にある「底面ボタン」も配備されている。本機では「マクロボタン」(M1/M2)という名称だ。
背面の大きな開口部には、巨大な冷却電動ファンが内蔵されている。プレイ中の振動や騒音はまずまずといったところだ。ボディーの要所要所はそれなりに熱くなったものの、本体を握っているグリップやボタン面はそれほど熱くならない。このあたりは、過去モデルの経験が生きているところなのだろう。
付属のACアダプターは最大65W出力に対応するもので、持ち運びやすいコンパクトサイズがうれしい。サードパーティー製のUSB PDアダプターを使う場合は、65W以上の出力でないと性能に制限が加わるので注意したい。
|
|
|
|
|
|
|
|
Copyright(C) 2026 ITmedia Inc. All rights reserved. 記事・写真の無断転載を禁じます。
掲載情報の著作権は提供元企業に帰属します。

IT・インターネット
ランキング IT・インターネット
アクセス数ランキング
- 1

Netflix値上げ 最安は月額990円(写真:ITmedia Mobile)28
話題数ランキング
- 1

「AIエージェント」が普及期に(写真:時事通信社)45
