


Qualcomm主催の「Snapdragon Summit 2026」では、最新の“AI”とそれを実現する半導体やソフトウェア技術についてさまざまな話題が語られた。今回は、特に興味深いと思った内容についてトピックを抽出して紹介したい。
●1bit AIモデルで何が可能なのか?
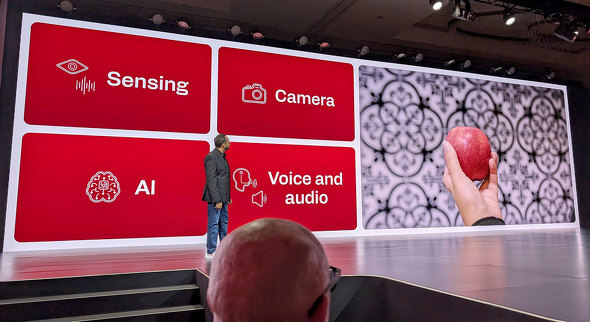
今回のSnapdragon Summitで興味を引いたデモの1つが、“スマートグラス”を使った物体認識だ。例えば、グラスをかけた状態で目の前に“リンゴ”を持ってくると、グラスは音声で“リンゴ(正確にはApple)”と答え、内蔵のカメラで実際に物体が何であるかを認識しているというもの。
グラスにはQualcommの最新SoCである「Snapdragon AR1+ Gen 1」や「Snapdragon AR1 Gen 1」が搭載されており、これにPrismMLを組み合わせることで、いわゆる「1bit AIモデル」での画像認識を実現できているのだという。
|
|
|
|
過去のレポートでも紹介してきたが、現在のTransformerをベースにしたAIモデルでは大量の行列演算を繰り返すことで推論を実現しており、この演算に用いる“値”の精度をFP8(浮動小数点)やINT8(整数)のような桁数(ビット数)で表している。
最近ではINT4やINT2といった“値”での計算処理が用いられることがあるが、これはビット数がそれぞれ4bitまたは2bitといった単位で減少していることを意味する。ビット数が減少することで得られるメリットは、推論で用いるモデルのデータが、ビット数の減少幅に合わせてサイズが小さくなっていくことにある。
例えば、INT8がINT4になることでサイズは半分になり、INT2であればINT8に比べて4分の1となる。演算処理もそれだけ軽くなるため、もしINT4やINT2に対応した演算装置がNPUやGPUといった“処理ブロック”に組み込まれていれば、処理の高速化が可能になる。
一方でデメリットとしては、本来であれば得られる計算結果がビット数の減少によって失われ(丸め込まれる)、精度の低下として表れる。そのため、用途によってモデルや演算精度の使い分けが重要になるというのがAI推論での基本だ。
そして、今回の1bit AIモデルだ。説明によれば、PrismMLの20億パラメータ(2B)を持つBonsai 2Bを使い、史上初のスマートグラス端末内でのローカル処理のみでマルチモーダル(視覚と言語処理)の1bit AIモデルを動作させることに成功したという。
|
|
|
|
ポイントとしては、PrismMLのBonsai 2Bでは4bit AIモデル相当の推論が可能ながら、メモリ使用量が4分の1、トークン生成速度で2倍というパフォーマンスを実現している。つまり、前述の画像認識デモ(+音声ガイド)は1bit AIモデルで実行されたということを意味する。
ただ前述のAI推論の基本に立ち返ったとき、1bit AIモデルでは何らかのトレードオフがあるわけで、実際この1bit AIモデルではどこまでのことが可能なのだろうか?
本件に関してデモを紹介していた米Qualcomm TechnologiesでパーソナルAI担当SVP兼GMのジアード・アスガー(Ziad Asghar)氏は次のように語っている。
「(1bit推論は)非常に重要であり、特にメモリ容量が非常に限られている小型デバイスでは、8bit AIモデルと比較してサイズだけで8分の1になり、(推論の実行に)1GBのDRAMが必要だったとして、1bit AIモデルでは125MBで済む。
これにより、さまざまなデバイスでAI処理の実行が可能になる。他方で、1bit AIモデルでは精度が多少失われることになるものの、PrismMLではビット数を減少させても精度をかなり維持できるような独自のソリューションを持っている。必要なのは、これで何ができるかであり、AIによって視覚的な手がかりを得られることにある。
|
|
|
|
例えば、実際に今この部屋で(スマートグラスに)質問をしたとして、ここにはたくさんの人がいて、その場所は自宅ではなくオフィスや会議室のような場所であると答えるだろう。これが外であれば、昼間で晴れているといった情報を教えてくれる。これがAIエージェントによる体験の向上で、もし実際に暗いレストランでメニューを翻訳したり、OCRを実行したりというのであれば、より高度なAI処理やカメラが必要になる。今、われわれがテーマにしているのは、いかに視覚情報をデバイスに取り込むかということにある」(アスガー氏)
つまり、スマートグラスに内蔵するタイプのAIモデルで求められるのは、スマートフォンなどに内蔵されているようなある程度の万能性を持ったAIモデルによるローカル処理ではなく、視覚情報などを取り込んでいかにユーザー体験を補助していくのかであり、そこにはスマートフォンなどとの役割の違いがあるという考えだ。
同様に、同社でAI担当バイスプレジデントのヴァイネシュ・スクマー(Vinesh Sukumar)氏も1bit AIモデルの限界と、適した用途で使うことの重要性を説明する。
「例えば、スマートグラスを使ってどのような機能が実現できるかを考えるべきであり、スマートグラス内に1GBのメモリしか搭載できないのであれば、そこでAI推論を動作させるには1bit AIモデルを使うしかないというのが実際だ。
スマートグラスでも、『エアコンをつけて』『電気を消して』といったコマンドによる制御は可能であり、特にAIモデルを作成するための特別なトレーニングは必要ない。こういったシンプルなオン/オフはそれだけで充分役に立つが、仮に「2+2は?」「Strawberryという文字にrは何個含まれている?」といった質問に答えるのは非常に難しい。
それはAI推論の世界であり、そもそもStrawberryという単語の意味を理解する必要がある。つまり、どれだけ訓練してもこうした問題の解決は1bit AIモデルには非常に困難であり、数年後には実現するかもしれないとしても、現状ではまだ最先端とはいえない。
画像認識においても、写真を取り込んで処理はできても、その内容を分析して情報を返してくれるような仕組みは1bit AIモデルには難しく、ハイブリッドAIのような形でクラウドを組み合わせる必要がある。どのようなアクションを実行したいかによって、その目的に合わせてモデルを呼び出すことが重要だ」(スクマー氏)
●Snapdragonは今後どのようにAIに最適化されていくのか?
ウェアラブルデバイスにおけるAI対応の課題は、AIモデルのオンメモリ展開における容量の制約にあったが、スマートフォンやPCに搭載されるSnapdragonではどのような形でAI最適化が進み、今後ハードウェアはどうなっていくのだろうか。ポイントをまとめてみた。
今回発表された「Snapdragon 8 Elite Extreme Gen 6」で目立った機能強化といえば、Prime CoreがモバイルSoCのCPUとしては初の5GHzを突破したことだ。
しかし地味と言っては失礼だが、CPUを含め全体にブラッシュアップが図られており、AI推論実行の上で下支えとなっている。
1つは「ANF(Adreno Neural Fusion)」と呼ばれる、Adreno GPUにおけるAI超解像にも利用されているニューラル処理用のMatrix Coreだ。
Hexagon NPUにおいてもTransformer専用の固定機能ブロックの追加やコンテキスト長の拡大に対応して、KV CacheやSoftmaxでのスワップアウトによる処理速度低下を防ぐことで高いトークン生成速度を維持している。
この他、ローカルSRAMを50%増量することで外部DRAMへのアクセスを最小限に抑え、NPU内部でコンテキストや推論を維持してアクセス遅延を減らす工夫が行われている。
そして注目は、Oryon CPUに搭載されたCPUコア間で共有L2キャッシュプールを動的配分するFlex Cacheだろう。AIエージェントの世界では与えられたタスク(目標)を完遂するために、別のAIエージェントを呼び出したり、あるいは必要なタスクを何度も立ち上げて目標に向かって再帰処理を繰り返すという、いわゆる「Orchestrator(指揮者)」的な役割がAIエージェントには与えられることになる。
ただ、基本的にユーザーの指示は具体的ではなく、その“意図”を理解してコンピュータが実行可能なタスクに分解する処理が発生することになり、再帰処理の“マスター”を担う部分がCPUの役割となる。
前出のスクマー氏によれば、実際にアクションを実行する前に全ての処理を完了する必要があり、多くのマルチスレッド処理を有効にすることが非常に重要になるという。この性能を生かすのがFlex Cacheの役割の1つであり、CPUコア間で発生するやり取りをL2キャッシュ内で完結させることで外部DRAMとのアクセスを最小限にし、パフォーマンス向上へと結びつくわけだ。
スクマー氏は、現状のモバイル(PC)SoCのAI処理には、3つのボトルネックが存在するという。1つは演算性能で、主に「Time to First Token(初回トークン生成における遅延)」において演算器(NPU)の性能がレスポンスを左右するという。前述のようにSnapdragonでは着実にこの部分を強化しており、改善が進んでいるといえる。
2つめがメモリの帯域幅で、「Time to First Token」をクリアすると、その後の生成トークンレートは帯域幅の壁にぶつかる。同氏によれば、特にスマートフォンやウェアラブルなどのモバイル機器の世界ではメモリ帯域幅に強い制約があり、基板設計上からLPDDR5を4チャンネル(毎秒約80〜100GB)で動かすのが物理限界になるという。
そして3つめに問題になるのがメモリ容量の壁で、旺盛なデータセンター需要からHBM増産でウェハーが奪われた結果、DRAM価格の高騰により、OEM側でメモリ容量を増やすことがコスト的に厳しくなっているという話だ。
3つめについては時間が解決するしかないが、2つめの問題解決の鍵となるのが初日の基調講演レポートでも触れられていた「HBC(High Bandwidth Compute)」だ。
以前のレポートでも説明したように、もともとはデータセンター向けSoCのDragonflyとセットで発表された技術であり、仕組み的には2026年6月に開催された「Investor Day 2026」の技術資料でもまとめられている。
「Near Memory Compute」と呼ばれるプロセッサコアの“ダイ”とメモリの距離を近付けて電力ロス低減(低発熱)とアクセス帯域向上を図る仕組みであり、消費電力やコスト面で優位にあるという。
とはいえ、データセンター向けのHBCをそのままモバイルに応用しようとすると発熱や電力消費が高すぎて機器設計やバッテリ枯渇の課題があるため、それをモバイル向けに最適化させようというのがポイントとなる。
詳細については2027年3月のMWCで発表されるというが、おそらくは2028年から2029年以降の実用化を目指す技術になるとみられる。
(取材協力:クアルコムジャパン)
|
|
|
|
|
|
|
|
Copyright(C) 2026 ITmedia Inc. All rights reserved. 記事・写真の無断転載を禁じます。
掲載情報の著作権は提供元企業に帰属します。

IT・インターネット
ランキング IT・インターネット
アクセス数ランキング
- 1

Google「Gemini 4 Agron」を発表(写真:ITmedia NEWS)11
話題数ランキング
- 1

Google「謎キーボード」に新作(写真:ITmedia NEWS)19
