


AIはプログラミングの世界で革命を起こしつつあるわけだが、ソフトウェア開発とは関係のない人たちに大きな恩恵を与えたのが、音声からの文字起こしではないだろうか。
以前は録音を聴きながら人間がタイピングして文字化するしかなかったわけだが、慣れた人でも1時間の書き起こしに数時間を要する。書き起こしのアウトソーシングを請け負う事業者もあり、それだけ需要も大きければ負担も大きい作業であった。
AIを使った文字起こしサービスは、開発中のβバージョンは無料で利用できたりしたものだが、現在はほとんどのサービスが開発を完了し、有料プランへと移行している。またボイスレコーダーとセットで文字起こしおよびサマリー化を自動化するサービスも人気があるところだ。筆者は今のところ「Plaud」を契約し、便利に使っているところである。
Plaudは、録音の音声データを元にサマリーを作るのは非常に得意である一方、単純な文字起こしの精度はそれほど良くないところが課題である。例えば話者が複数人いた場合の話者判別は、インタビュー記事や対談記事などを執筆する上で欠かせないところである。
|
|
|
|
インタビュー取材は、質問に対する回答という形で聞き手と話し手が分離されているが、立ち話のような雑談では誰かがその場を仕切るというわけでもなく、会話や相づちがかぶったり、明確なQAスタイルになっていない。こうした録音で話者を分離するのは、既存の日本語向け音声書き起こしサービスではかなり難しいようだ。
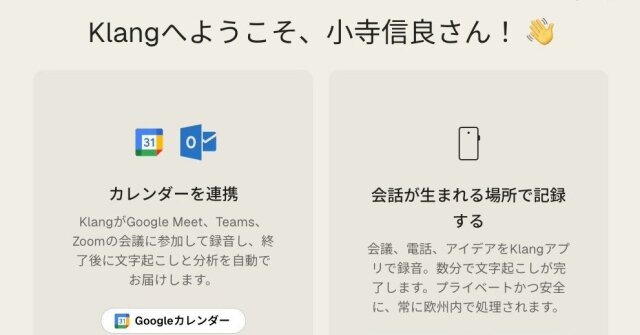
現在いろんなサービスを試してみているところだが、その中でも今後注目しておきたいのが、スウェーデンの「Klang」というサービスである。スウェーデン語モデル「Klang Pianissimo」の開発経験をベースに、日本語音声認識モデルの学習を近く開始する予定で、研究開発や海外展開のため新たに約2.4億円の資金調達を行った。日本はその重点市場の1つである。
これまで北欧を中心に事業を展開しており、DACH地域(ドイツ、オーストリア、スイス)とベネルクス地域(ベルギー、オランダ、ルクセンブルク)での展開も進めている。2026年8月には日本語版の提供を開始している。ただし現在のモデルはKlang Pianissimoではなく、別の日本語モデルだ。
●実際の結果
先日、京橋で開催された「CREATORS EDGE 2026」というイベントを取材した。写真・映像クリエイターのセミナーと、機材展示が同時に見られるという展示会である。Plaudのレコーダーを回しっぱなしにして各ブースを取材し、途中知り合いのカメラマンたちに会ったので、そこで立ち話的に情報交換をした。
|
|
|
|
一般的に、テーマが異なる話が同じ録音ファイルに存在すると、AIによるサマリーは、統一されたテーマを探そうとするので、うまくいかないことが多い。加えて多数の話者が入れ替わり立ち替わり登場するため、ベタの書き起こしも話者の切り分けもあまりうまくいかない。
この録音ファイルをKlangにかけてみたところ、かなり良い結果が得られた。ベタの書き起こしでは、話者が8人に分けて認識されていた。実際この切り分けは正しい。同じ録音部分の書き起こしを比較すると、Plaudは話者の切り分けがうまくいかないために文字化できていない部分がある一方で、Klangでは話者分離が正確で、それぞれを細かく書き起こしていることが分かった。
一方サマリーは、Plaudが得意とするところである。特に指示しなくても、複数のテーマに対するサマリーができていた。Plaudは言語認識に際して使用するAIモデルやテンプレートが選択できるので、割と期待通りの成果が得られる。
一方Klangのサマリーでは、一番長い雑談ブロックの部分だけが抽出されていた。そこで以下のような指示を出して再構築してもらった。
「この録音は、展示会での複数のブース取材を録音したものです。録音内容から各ブースの取材の切れ目を推測し、それぞれのブース取材に対するサマリーを制作してください。」
|
|
|
|
するとKlangは、各ブース取材と、ブース取材以外の雑談パートがあることを認識し、それぞれのサマリーを作るというアプローチを開始した。
「展示会取材の内容を確認いたしました。音声全体を分析した結果、明確な「ブース取材」と判断できる区間と、そうではない区間(小寺信良様ご本人への単独インタビュー・雑談パート)が混在していることが分かりました。それぞれを区別しつつ、ブース単位でサマリーをまとめた文書を作成します。」
日本語モデルの学習と評価はまだこれからだというが、日本語の指示に正確に反応しており、現在のモデルでもかなり良い結果が得られている。
●アプローチが異なる話者分離技術
Klangの特徴は、話者分離にありそうだ。一般的に話者識別の標準的なアプローチは、録音された音声を「話者埋め込み」、つまり声の響きをあらわす数値のリストに変換することである。同じ人物と思われる音声には近い数値が埋め込まれる。別の話者に対しては、離れた数値が埋め込まれる。
このアプローチの特徴は、話されている内容に関する要素は無視されるということだ。つまり純粋に声の質や響きから話者を分離する。しかしこの方法は、録音の揺れに左右される。例えば途中でレコーダーの位置が変わったり、相手の位置や距離が変わったりすると、録音状態が変わるので、同一人物であっても近い数値にはならなくなる。
そこでKlangが採ったアプローチは、会議をまたいで同一人物を追うため、話者埋め込みの変動が「どの程度異なるか」だけでなく、「どのように異なるか」まで踏み込むという方法である。公開されているソースから約8000の異なる声を集めたデータセットを作成し、それぞれについて埋め込みを計算した。埋め込みのばらつき方に偏りがあることを踏まえて空間を補正し、同一話者を追跡しやすくしている。
これらのアプローチは、主にヨーロッパの音声で検証されたものだが、声の特徴を空間補正しながら追跡するというアプローチは、言語が変わっても動きやすいようだ。Klangの書き起こしログを一通り読んでみたが、同音異義語による変換の間違いはかなり少ない印象だ。一部数字の読み上げを、漢数字で書き起こしている部分があるにはあるが、意味は分かる。国外の言語AIエンジンでここまでやれるのは珍しい。
スウェーデンKlang AIの共同創業者兼CTO(最高技術責任者)、アンドレアス・アルゲリウス氏によれば、ヨーロッパ言語とは構造が異なる日本語の文字起こしで課題となるものの1つが、人名や地名を正しい漢字で表記することだという。読み方だけではどの漢字を使うべきか特定できない場合があり、正しい表記を選ぶために、追加の文脈が必要になることがあるという。
実はアルゲリウス氏は、以前東京で4年ほど働いていた経験があり、日本には特別な思い入れがあるという。日本語は欧州の言語とは大きく異なるからこそ、日本語の特性に合わせた学習と評価が必要で、スウェーデン語モデルPianissimoの開発で学んだ学習データの質を重視する進め方を、日本語にも生かす予定となっている。
●話者が分離できれば、日々の雑談が宝の山に
何かのアイデアや考え方のヒントは、一人でうんうん考えていても答えが出ないことが多い。ただそれを頭の隅に入れた状態で、全然関係ない人と立ち話していると、そこでの話から重要な示唆が得られることがある。とはいえ、雑談している間に急にメモとか取り出すのも、話の流れを止めてしまうので良くない。そんなとき、レコーダーを回しっぱなしにしていればいい。
これまで音声録音はさあ録るぞといって開始し、話終わったかなと思ったところで停止していた。だがそれはあくまでも人間があとで聞き返す都合上、不要部分を録音ファイルに入れたくないというだけの話である。録音自体は人間が聞かず、AIによる書き起こしだけ読むというのであれば、1日中でも回しっぱなしにしとけばいい。
一方で、周囲がガヤガヤしているところでの雑多な録音は、なかなかAIの書き起こしツールには引っかからない。話者が分離できないために、うまく文字起こしできないのだ。Klangのアプローチは、こうした問題を解決できる可能性がある。
もう1つ、音声書き起こしに加えられる要素がある。われわれは取材や話をしているときに、よくスマホで写真を撮っている。参考のためだったり、記事化するためだったり、あとで話を思い出すためであったりとその目的はさまざまだが、とにかくパシャッとメモ撮影しているのだ。
こうした写真には、撮影時のタイムスタンプがメタデータとして格納されている。また録音ファイルも、時刻が設定できるレコーダーであれば、タイムスタンプが格納されている。録音データと写真データをAIに読み込ませれば、何を喋っているときにどの写真が撮られたのかが照合できるはずだ。書き起こしの補強材料として、写真に記録された情報が利用できるはずである。
これまで書き起こしAIは、音声ファイルしか読み込めなかった。同時に撮影された写真や動画も読み込めるようになれば、さらに書き起こし精度は向上するだろう。
昨今はカメラ付きAIグラスも多数登場している。録音しながらのメモ撮影も、それぞれの専用デバイスを使わずに可能になるだろう。今後音声書き起こしやサマリー化は、録音して議事録をまとめるみたいな用途以上に拡大する可能性が高い。
おそらくそのキーとなる技術は、話者分離だ。今から多くの音声書き起こしサービスの動向をつかんでおくのは、今後の社会活動をより効率化するのに役立つものと思われる。
|
|
|
|
このニュースに関するつぶやき
-
居酒屋で隣近所の卓に聞き耳を立てるAI。もう家で飲むしかないねー…
-
 0人
 0件
-
|
|
|
|
Copyright(C) 2026 ITmedia Inc. All rights reserved. 記事・写真の無断転載を禁じます。
掲載情報の著作権は提供元企業に帰属します。

IT・インターネット
ランキング IT・インターネット
アクセス数ランキング
- 1

「INFOBAR」約8年ぶりの新製品(写真:ITmedia Mobile)69
話題数ランキング
- 1
「INFOBAR」約8年ぶりの新製品(写真:ITmedia Mobile)69
