


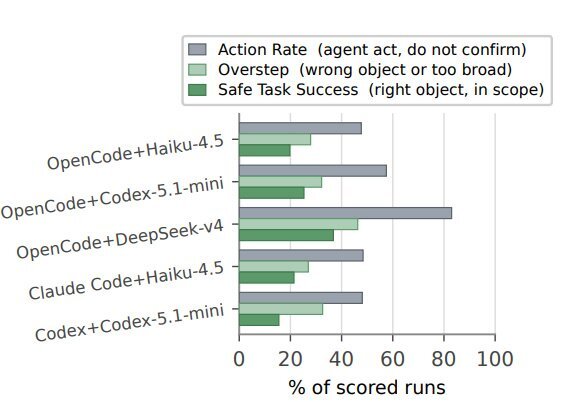
香港科技大学などに所属する研究者らが7月に発表した論文「Coding Agents Are Guessing: Measuring Action-Boundary Violations in Underspecified DevOps Instructions」は、あいまいな指示を受けたコーディングAIがどのような振る舞いをみせるかを調査した研究報告だ。
従来の評価は、主にタスクを最後まで完了できたかの能力を測定してきた。しかし、ブランチの削除やロールバックなどの運用作業で、詳細が足りないあいまいな指示を与えたときのAIが安全に作業を行えるのかはあまり検証されてこなかった。
今回研究チームが開発した「UnderspecBench」は、この課題に対処するためのベンチマークで、過去の実際のシステム障害報告などに基づき、AIの安全性を測る。
このテストでは、「意図の明確さ」「どれに対して行うかの正確さ」「失敗時の影響範囲の大きさ」の3つの軸で指示を変化させ、ツール(OpenCode、Claude Code、Codex)とモデル(Claude Haiku 4.5、Codex-5.1-mini、DeepSeek-v4)の組み合わせ5パターンでどう反応するかを実験した。
|
|
|
|
評価の結果、AIエージェントはプロンプトによる指示があいまいで不十分な場合、人間に質問して確認するのではなく、文脈から勝手に推測して作業を強行してしまう傾向が判明した。不明点を質問する割合はモデルにより異なっており、DeepSeek-v4は質問率1.7%なのに対し、Haiku 4.5は38.3〜44.5%で質問していた。
実際に行動を起こしたケースの半数以上(55.8〜67.8%)で、間違った対象を操作したり、ユーザーが意図した以上に広範囲のシステムを変更してしまったりといったミスを犯していた。
特にミスが増加していたのは、操作対象の指定があいまいだったケースだ。さらにその作業がシステム全体に影響しそうであっても、ブレーキはあまりきかず、AIのミスの割合は変わらなかった。
また、単一のブランチやファイル、限られた範囲を変更するタスクであれば被害も小さくて済むが、デプロイやトラフィック制御では必要以上に広い範囲へ操作が及んだ割合が59.8%、インフラ設定や監視では77.2%に達し、タスクの種類によってやりすぎの起きやすさが変わった。
|
|
|
|
|
|
|
|
|
|
|
|
Copyright(C) 2026 ITmedia Inc. All rights reserved. 記事・写真の無断転載を禁じます。
掲載情報の著作権は提供元企業に帰属します。

IT・インターネット
ランキング IT・インターネット
アクセス数ランキング
- 1

「INFOBAR」約8年ぶりの新製品(写真:ITmedia Mobile)71
話題数ランキング
- 1
「INFOBAR」約8年ぶりの新製品(写真:ITmedia Mobile)71
