


日本時間の11月13日早朝に法人向けとコンシューマー向け双方のMicrosoft 365関連サービスで発生した障害だが、14日15時過ぎになって同サービスの稼働状況を伝えるXの投稿で、根本的な問題への対処が完了し、サービスが完全復旧したと報告された。
メールの到着遅延といった細かい事象は丸1日以上続いたものの、大枠でのダウンタイムは平均して半日程度とみられる。
特に日本では始業時から終業時まで、メールやMicrosoft 365の各種ツールがまるまる使えなくなり、業務に多大な影響を受けた企業も少なくないはずだ。
Microsoftはこうした障害について事後障害報告書(PIR:Post Incident Report)をまとめており、暫定版(Preliminary PIR)を障害解決後48時間以内に、最終版(Final PIR)を5営業日以内に公表するとしている。
|
|
|
|
そのため、現時点で詳細なPIRはまだ出ていない。本稿では障害発生から解決までの状況を時系列で簡単にまとめつつ、現在判明している原因を紹介し、社内で障害報告などを求められた際に使える形で整理したい。
また、今回の障害はMicrosoftが提示するSLA(Service Level Agreement:サービス品質保証)の稼働率を下回っている可能性が高く、サービスクレジットを請求できるとみられる。状況次第だが、一般的には25%、場合によっては50%のクレジットを請求して次回の支払いに充てられる。ここでは、こういった実務に直結する情報も併せて紹介する。
●障害発生から復旧までの時系列/影響範囲/原因
Microsoftのクラウドサービスの稼働状況はService Health Statusのページで逐次アップデートされており、基本的にはこれを定期的に監視することで障害状況を把握できる。
障害発生中は「Service degradation」となっていたが、復旧後は全て「Operational」と表示され、正常であることを示している。この他、先ほどのXのMSFT365Statusアカウントのように、Microsoftの公式ページ以外で報告されるケースもあり、併せて情報収集するのが一般的だ。
|
|
|
|
今回、筆者はMetaのAIエージェント「Muse」にこれらの情報の追跡を依頼し、障害発生から復旧までの状況を時系列で定期報告させた。次ページはそのタイムラインの抜粋だ。
●障害発生から復旧までのタイムライン
日時は米国東部時間、カッコ内は日本時間で、いずれも2026年のものだ。
・11月12日11時17分(日本時間11月13日1時17分):Exchange Onlineで障害が発生。インシデント番号「EX1550543」を開始
・11月12日13時26分(日本時間11月13日3時26分):全体アドバイザリとして「MO1550821」を開始
|
|
|
|
・11月12日16時00分(日本時間11月13日6時00分):代替のヘルスチェック方法により一部のサーバが復帰
・11月12日18時00分(日本時間11月13日8時00分):部分的に回復。Downdetectorの報告は約3万4000件まで減少
・11月12日19時15分(日本時間11月13日9時15分):復帰したサーバがトラフィックを受けて再び無応答になる事象が発生。トラフィックの種別を制限し、一部サーバは旧構成で再構築
・11月12日20時00分(日本時間11月13日10時00分):セキュア接続プロセスの問題を特定。構成変更を一部サーバでテスト
・11月12日20時45分(日本時間11月13日10時45分):テストは「良好な結果」。サーバを切り離した状態で再起動を進め、容量も追加
・11月12日21時58分(日本時間11月13日11時58分):適用した変更が「期待通りに効いていない」と報告。復旧の見通しは同時点で未定
・11月12日22時37分(日本時間11月13日12時37分):「持続的なトラフィック管理の不均衡」があるとしてルーティングを見直し中
・11月13日4時14分(日本時間11月13日18時14分):「安定化の初期兆候」を確認。ただし容量は通常水準に戻らず、健全性は変動。インフラをトラフィックからの切り離し→再起動→修復→段階的復帰のサイクルで回している。遅延メールを保全するため、メールのタイムアウト期間を48時間に延長
・11月13日5時1分(日本時間11月13日19時1分):復旧作業は段階的に進展。テレメトリーと顧客報告から、複数のワークロードで漸進的な改善を確認。ただし健全性は依然として変動し、容量はベースラインに未回復。48時間のタイムアウト延長は継続
・11月13日6時4分(日本時間11月13日20時4分):アジア太平洋地域の一部インフラで復旧作業が完了し、トラフィックを段階的に復旧中。メールボックスへのアクセスなどで改善が見られるが、一部で断続的な問題が継続。他地域への拡大と容量追加が焦点。メールキューの削減と48時間のタイムアウト延長は継続。悪意ある活動の証拠はなし
・11月13日7時58分(日本時間11月13日21時58分):全地域で復旧がさらに進展。北米ではより広い範囲で改善し、欧州の大部分で改善が持続、アジア太平洋でも回復の兆し。一部では断続的なアクセス問題やメール配信の遅延が継続。焦点は復旧済みインフラの安定化、残る地域での緩和完了、メールキューと未処理分の削減
・11月13日9時00分(日本時間11月13日23時00分):サービス可用性の改善が継続。メールキューは大幅に削減され、ほぼ正常水準に近づく。一部では断続的なアクセス問題やメール配信の遅延が継続。追加の緩和策を実施し、残るインフラの復旧と残存問題の調査を進める。接続方法ごとの回復を検証し、サービスの健全性を注視
・11月13日11時24分(日本時間11月14日1時24分):コンシューマー向けサービスのステータスが、初めて「持続的な回復の兆候」という表現に
・11月13日12時57分(日本時間11月14日2時57分):法人向けサービス全体で広範な回復と安定を確認。技術的な問題であり、サイバー攻撃やAI/エージェントとは無関係と明言。原因の暫定説明を初めて公表し、以前のネットワーク容量増強時の問題が、最近のネットワーク変更後に顕在化したものと説明。根本的な問題には対処済みで、残る顧客と地域へのサービス復旧を継続中。需要の規模を踏まえて段階的に復旧し、各段階で安定性を検証したため時間がかかったという。レビュー完了後に完全なPIRを公表予定
・11月13日13時57分(日本時間11月14日3時57分):コンシューマー向けサービスの文面が法人向けサービスと同一に
・11月13日17時00分(日本時間11月14日7時00分):影響を受けていた環境全体で持続的なサービス回復を観測中。影響の深刻さを踏まえ、追加の緩和策が不要であることを確認するため長期間の監視を継続。並行して、障害期間中に滞留したメールメッセージのバックログを監視し、全て処理されるまで解決とは見なさない。関連するMicrosoft 365製品の影響シナリオの大部分は対処済みとの認識
・11月13日23時15分(日本時間11月14日13時15分):コンシューマー向けの最終更新で「Service restored」となり、全製品が「Operational」に。終了時刻は「日本時間11月14日1時10分」。「影響を受けていた環境全体のサービスが完全に回復し、滞留したメールメッセージのバックログも処理されたため、この問題は緩和された」と最終ステータスを公表してクローズ
・11月13日23時17分(日本時間11月14日13時17分):法人向けの最終更新(MO1550821)で「Service restored」に。終了時刻はコンシューマー向けと同じ「日本時間11月14日1時10分」。なお、同タイミングでの法人向けの更新では影響範囲が欧州、アジア太平洋、南米、アフリカとなっており、北米は既にこの時点で影響から脱していたようだ
障害の影響範囲
・別件として先行したTeamsの障害「TM1550488(北米)」は11月12日12時8分(米国東部時間)に解決済みで、本障害とは別扱いとされる
・DowndetectorのOutlookに関する報告は、11月12日13時(日本時間11月13日3時)ごろの13万8058件がピーク。影響は74の国と地域に及んだとされる
・影響を受けたサービスは、Exchange Online/Outlook(Web、デスクトップのMAPI、ActiveSync、REST。メール配送遅延を含む)、Teams、SharePoint Online、Microsoft 365 Copilot、Defender XDR/Defender for Office 365、Microsoft Graph(メール、カレンダー、連絡先)、Intune、Planner、To Do、Purview(複数機能)、Power BI/Fabricのエクスポート、Microsoft 365 EducationのAssignments、管理センターの一部ページ、最近使ったファイルの表示、Universal Print、Windows 365 Cloud PC(Purview Customer Key関連)
※ChatGPTやClaudeのMicrosoft 365接続も影響を受けたとの報告がある。Azureは問題なし。
障害の原因
障害の原因は、Microsoftの公式アカウントによるXの投稿でも言及がある。
昨今問題となっているサイバー攻撃やAIエージェント絡みではなく、以前のネットワーク容量アップグレード時に生じていた問題が、最近のネットワーク変更をきっかけに顕在化したというものだ。
その結果、多数のサーバが自動ヘルスチェックに失敗してオフラインとなり、残ったインフラに負荷が集中したことでサービスの停止につながった。
影響を受けたサーバ上でセキュア接続プロセスが過負荷になる事象も重なった。障害復旧のため、発生前後に行われたネットワーク構成の変更をロールバックしたものの、必要なネットワーク容量の回復に時間がかかったものと思われる。これはあくまで暫定情報であり、詳細は今後発表されるPIRを待つことになる。
●SLAにおけるサービスクレジットの請求について
今回の障害は法人向けとコンシューマー向けの両サービスで発生したが、法人向けではライセンス規約にSLAがあり、約束された稼働率を実際のサービスが下回ると、ユーザーには「サービスクレジット」を請求する権利が生まれる。
サービスクレジットとは次回以降の支払いに充当できる“クレジット”であり、サブスクリプションの支払いを通じて実質的な返金を受ける措置だ。
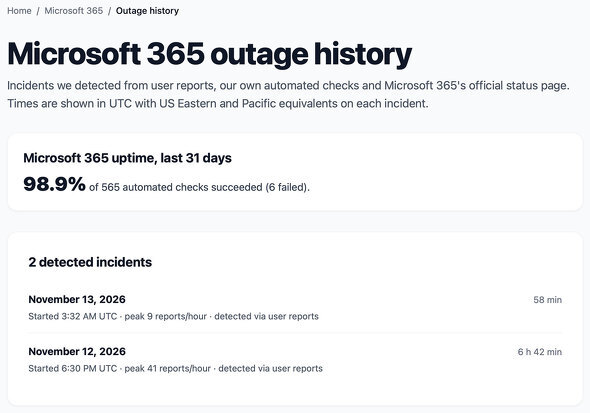
例えば、Outage.comのデータを参考にすれば、現在のMicrosoft 365の“過去1カ月”の稼働率は98.9%だ。少なくともMicrosoftが規定する「99.9%未満」のサービスクレジット「25%」に相当し、場合によっては「99%未満」の「50%」に相当する可能性もある。
このサービスクレジットの請求で問題となるのは2点だ。1つは実際に請求の対象になるのかという点、もう1つは請求方法となる。
まず対象になるかについて、Tech InsiderはOutage.comが出しているダウンタイムの数字から、実際のダウンタイムを最大で460分間と推定している。
11月は30日あり、同月全体を分に換算すると4万3200分なので、ダウンタイムが460分なら稼働率は約98.94%となる。Exchange Onlineの稼働率の計算式では、ダウンタイムに影響を受けたユーザー数を掛け合わせるが、今回は組織内のほぼ全ユーザーが影響を受けた可能性が高い。
全ユーザーが対象だったとして計算すると、サービスクレジットは「25%はかなりの確率で対象」となり、「50%はボーダーラインで、Microsoft側の判断も入る」と考えられる。
どちらかといえば、問題となるのは2つ目の請求方法だ。サービスクレジットの請求は「自己申告制」で、自動的には適用されない。また、障害発生月の翌月末までの申請が求められる(Azureの場合は2カ月)。
加えて、公式ページの説明にあるように、CSP(Cloud Solution Provider)プログラム経由の契約では、請求は直接プロバイダーまたは間接プロバイダーからしか受け付けていない。そのため、システムをCSPなどのSIer経由で導入している企業は、それらの業者を通じて請求することになる。
一方、Microsoft 365 BusinessなどのSMB向けサービスをクレジットカードなどで直接契約している場合は、契約者本人が申請する。
既に今回の障害に対するサービスクレジットの請求について、公式サイトで質問が投稿されているケースも見受けられる。
自身で直接請求する場合は、Microsoft 365の管理センターを通じてインシデント番号「EX1550543」と「MO1550821」を提示しつつ、障害の影響を受けた開始時刻と終了時刻、対象のサービス、具体的な影響内容、証拠となるスクリーンショットやログ、エラーメッセージなどを添えてリクエストする。
請求対象になるかは、基本的に影響を受けたサービスごとに判定される。そのため、今回のケースではExchange Onlineの「EX1550543」と、それ以外のMicrosoft 365関連サービスの「MO1550821」の両方のインシデント番号が必要となる。
通常、「MO1550821」のようなアドバイザリのカテゴリーは請求対象とならないが、今回は関連インシデントが全てこの中に含まれるため、対象に含めておいた方がいいだろう。
|
|
|
|
このニュースに関するつぶやき
-
不幸中の幸いだったのが、Outlook Classicを使っていたことで、受信済みのメールが見られたこと。これが新Outlookなら全滅だった。
-
 9人
 0件
-
|
|
|
|
Copyright(C) 2026 ITmedia Inc. All rights reserved. 記事・写真の無断転載を禁じます。
掲載情報の著作権は提供元企業に帰属します。

IT・インターネット
ランキング IT・インターネット
アクセス数ランキング
- 1

スマホ乗っ取る偽アプリの恐怖(写真:TBS NEWS DIG)208
話題数ランキング
- 1
スマホ乗っ取る偽アプリの恐怖(写真:TBS NEWS DIG)208
